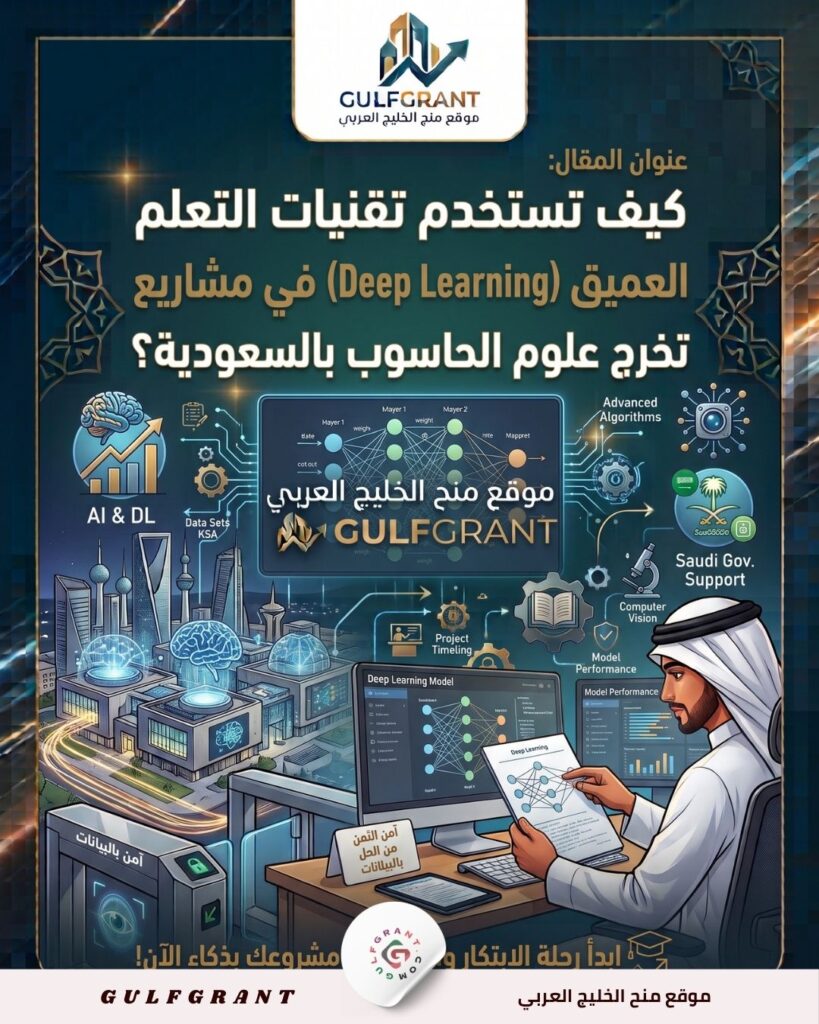
تعد الاستفادة من تقنيات التعلم العميق (Deep Learning) في مشاريع تخرج علوم الحاسوب بالسعودية خطوة أساسية لكل طالب جامعي يطمح لتقديم مشروع تقني مبتكر ومطبق لمعايير رؤية المملكة في التحول الرقمي والذكاء الاصطناعي.
يمثل مشروع التخرج المحطة الأهم في مسيرة طالب علوم الحاسوب، حيث يترجم السنوات النظرية إلى تطبيقات عملية قادرة على حل مشكلات حقيقية في قطاعات الصحة، النقل، أو المدن الذكية. يواجه العديد من الطلاب تحديات في اختيار نماذج التعلم العميق المناسبة، جمع البيانات، وتجنب التعقيدات البرمجية غير الضرورية. يهدف هذا المقال إلى توفير دليل شامل وعملي يوضح لك كيفية توظيف تقنيات التعلم العميق في مشروع تخرجك بكل كفاءة وثقة.
اختيار فكرة المشروع وتحديد نطاق التطبيق العملي
تبدأ رحلة النجاح في مشاريع التعلم العميق باختيار فكرة واقعية ومحددة تعالج مشكلة محلية ملحة يمكن حلها باستخدام الشبكات العصبية والبيانات المتاحة.
- التركيز على مجالات ذات أولوية وطنية مثل الرعاية الصحية الرقمية أو معالجة اللغات الطبيعية باللهجة المحلية.
- تجنب الأفكار المعقدة جداً التي تتطلب إمكانات حوسبية هائلة تتجاوز قدرات فريق العمل.
- التأكد من توفر مجموعة بيانات (Dataset) كافية وموثوقة لتدريب النماذج بفاعلية.
“اختيار فكرة محددة وقابلة للتنفيذ هو السر الحقيقي وراء نجاح مشاريع الذكاء الاصطناعي دون تعثر منتصف الفصل.”
جمع البيانات وتجهيزها للتدريب الآلي
تعتمد دقة وقوة أي نموذج تعليق عميق بشكل مباشر على جودة وكمية البيانات المستخدمة في مرحلة التدريب والتحقق الميداني.
- تنظيف البيانات من القيم المفقودة والشوائب التي قد تضلل نموذج التعلم.
- تقسيم البيانات إلى مجموعات للتدريب، التحقق، والاختبار بنسب مدروسة.
- استخدام تقنيات زيادة البيانات (Data Augmentation) في حال كانت العينة محدودة.
جدول مقارنة بين أطر عمل التعلم العميق الشائعة في المشاريع
| إطار العمل (Framework) | لغة البرمجة الأساسية | سهولة الاستخدام للمبتدئين | الدعم المجتمعي والتوثيق |
|---|---|---|---|
| TensorFlow / Keras | بايثون (Python) | متوسطة إلى سهلة | واسع جداً ودعم رسمي قوي |
| PyTorch | بايثون (Python) | عالية ومرنة للغاية | ممتاز ومفضل في الأبحاث |
| Scikit-Learn | بايثون (Python) | سهلة جداً | ممتاز للتعلم الآلي التقليدي |
اختيار بيئة التشغيل والموارد الحوسبية المناسبة
تتطلب خوارزميات التعلم العميق قدرات معالجة عالية لا توفرها الحواسيب الشخصية العادية، مما يحتم استغلال الموارد السحابية المتاحة للطلاب.
- استخدام منصات الحوسبة السحابية المجانية مثل Google Colab أو Kaggle Kernels.
- استغلال معالجات الرسوميات (GPUs) المتاحة سحابياً لتسريع عملية تدريب النماذج.
- إعداد بيئة التطوير المحلية (Local Environment) باختيار الإصدارات المتوافقة للمكتبات.
“الاعتماد على الموارد السحابية المتاحة يحل مشكلة ضعف أجهزة الحاسوب الشخصية ويسرع إنجاز مهام التدريب الضخمة.”
تقييم الأداء واختبار النماذج البرمجية
بمجرد اكتمال تدريب النموذج، يأتي دور قياس أدائه باستخدام مقاييس علمية دقيقة لضمان قدرته على التعميم مع البيانات الجديدة.
- حساب دقة النموذج (Accuracy)، الحساسية (Recall)، والدقة الإيجابية (Precision).
- استخدام مصفوفة الارتباك (Confusion Matrix) لتحديد نقاط ضعف التصنيف.
- تجنب الوقوع في فخ الإفراط في التخصيص (Overfitting) عبر تقنيات التنظيم.
توثيق المشروع وكتابة التقرير الأكاديمي النهائي
يتطلب مشروع التخرج تقريراً أكاديمياً رصيناً يشرح المنهجية المتبعة، الهندسة المعمارية للشبكة العصبية، والنتائج المستخلصة بالأرقام والرسوم البيانية.
- صياغة مقدمة واضحة تبين مساهمة المشروع وأهدافه العلمية والتطبيقية.
- إرفاق الأكواد البرمجية منظمة ومعلقة بوضوح على منصة GitHub للتقييم.
- تقديم عرض توضيحي (Presentation) يبرز قيمة التطبيق ومخرجاته العملية.
الأسئلة الشائعة
هل يتطلب استخدام التعلم العميق في مشروع التخرج خلفية رياضية معقدة؟
يتطلب الأمر فهماً أساسياً للجبر الخطي، التفاضل والتكامل، والإحصاء، ولكن تتيح المكتبات البرمجية الحديثة تطبيق النماذج بسهولة دون اشتقاق معادلات معقدة يدوياً.
ما هو الفرق بين التعلم الآلي التقليدي والتعلم العميق في المشاريع؟
التعلم الآلي التقليدي يعتمد على استخراج الميزات يدوياً ويتطلب بيانات أقل، بينما يقوم التعلم العميق عبر الشبكات العصبية باستخراج الميزات تلقائياً ويحتاج لبيانات ضخمة.
هل يمكنني استخدام Google Colab مجاناً لتدريب نماذج مشروعي؟
نعم، يوفر Google Colab موارد حوسبة مجانية تشمل معالجات رسوميات تفيد جداً في تدريب النماذج الطلابية المتوسطة والمتقدمة.
كيف أتأكد من أن بيانات مشروعي كافية لتدريب نموذج عميق؟
يعتمد ذلك على تعقيد المهمة؛ فكلما زادت تعقيدات المشكلة زادت الحاجة لآلاف العينات، ويمكن الاستعانة بمجموعات بيانات جاهزة متاحة علماً.
ما هي لغة البرمجة الأكثر طلباً لمشاريع التعلم العميق؟
تعتبر لغة بايثون (Python) اللغة المعيارية والأكثر استخداماً عالمياً ومحلياً لدعمها الهائل لمكتبات الذكاء الاصطناعي.
كيف أتجنب مشكلة Overfitting أثناء تدريب الشبكة العصبية؟
عبر استخدام تقنيات مثل Dropout، زيادة حجم البيانات، أو إيقاف التدريب مبكراً (Early Stopping) عندما تتوقف دقة التحقق عن التحسن.
هل يجب أن أصمم شبكة عصبية من الصفر أم أستخدم نماذج جاهزة؟
يُفضل غالباً استخدام تقنية التعلم بالانتقال (Transfer Learning) والنماذج الجاهزة المدربة مسبقاً وتعديل طبقاتها الأخيرة لتناسب مشكلتك.
أين أجد مجموعات بيانات (Datasets) مناسبة لمشروع التخرج؟
تتوفر منصات عالمية ضخمة مجانية مثل Kaggle وUCI Machine Learning Repository بالإضافة إلى قواعد بيانات محلية حسب طبيعة المشروع.
كيف أقسم درجات تقييم مشروع التخرج بين الكود والتقرير؟
توزع الدرجات عادة بين فكرة الابتكار، جودة التطبيق البرمجي، دقة النتائج المعروضة، وقوة العرض التوضيحي والتقرير المكتوب.
لمن أتوجه في حال واجهت عطلاً برمجياً معقداً في كود الشبكة؟
يمكنك الاستعانة بمشرفك الأكاديمي، مناقشة الزملاء، أو البحث في المنتديات التقنية المعتمدة مثل Stack Overflow والمجتمعات البرمجية.
الموارد الخارجية والمواقع الرسمية المفيدة
يمكنكم الاطلاع على الجهات والمصادر الرسمية ذات الصلة بالذكاء الاصطناعي في المملكة:
خاتمة
استخدام تقنيات التعلم العميق في مشاريع تخرج علوم الحاسوب بالسعودية يمنحك ميزة تنافسية كبرى ويهيئك للاندماج السريع في قطاع التقنية والابتكار الوطني.